KI
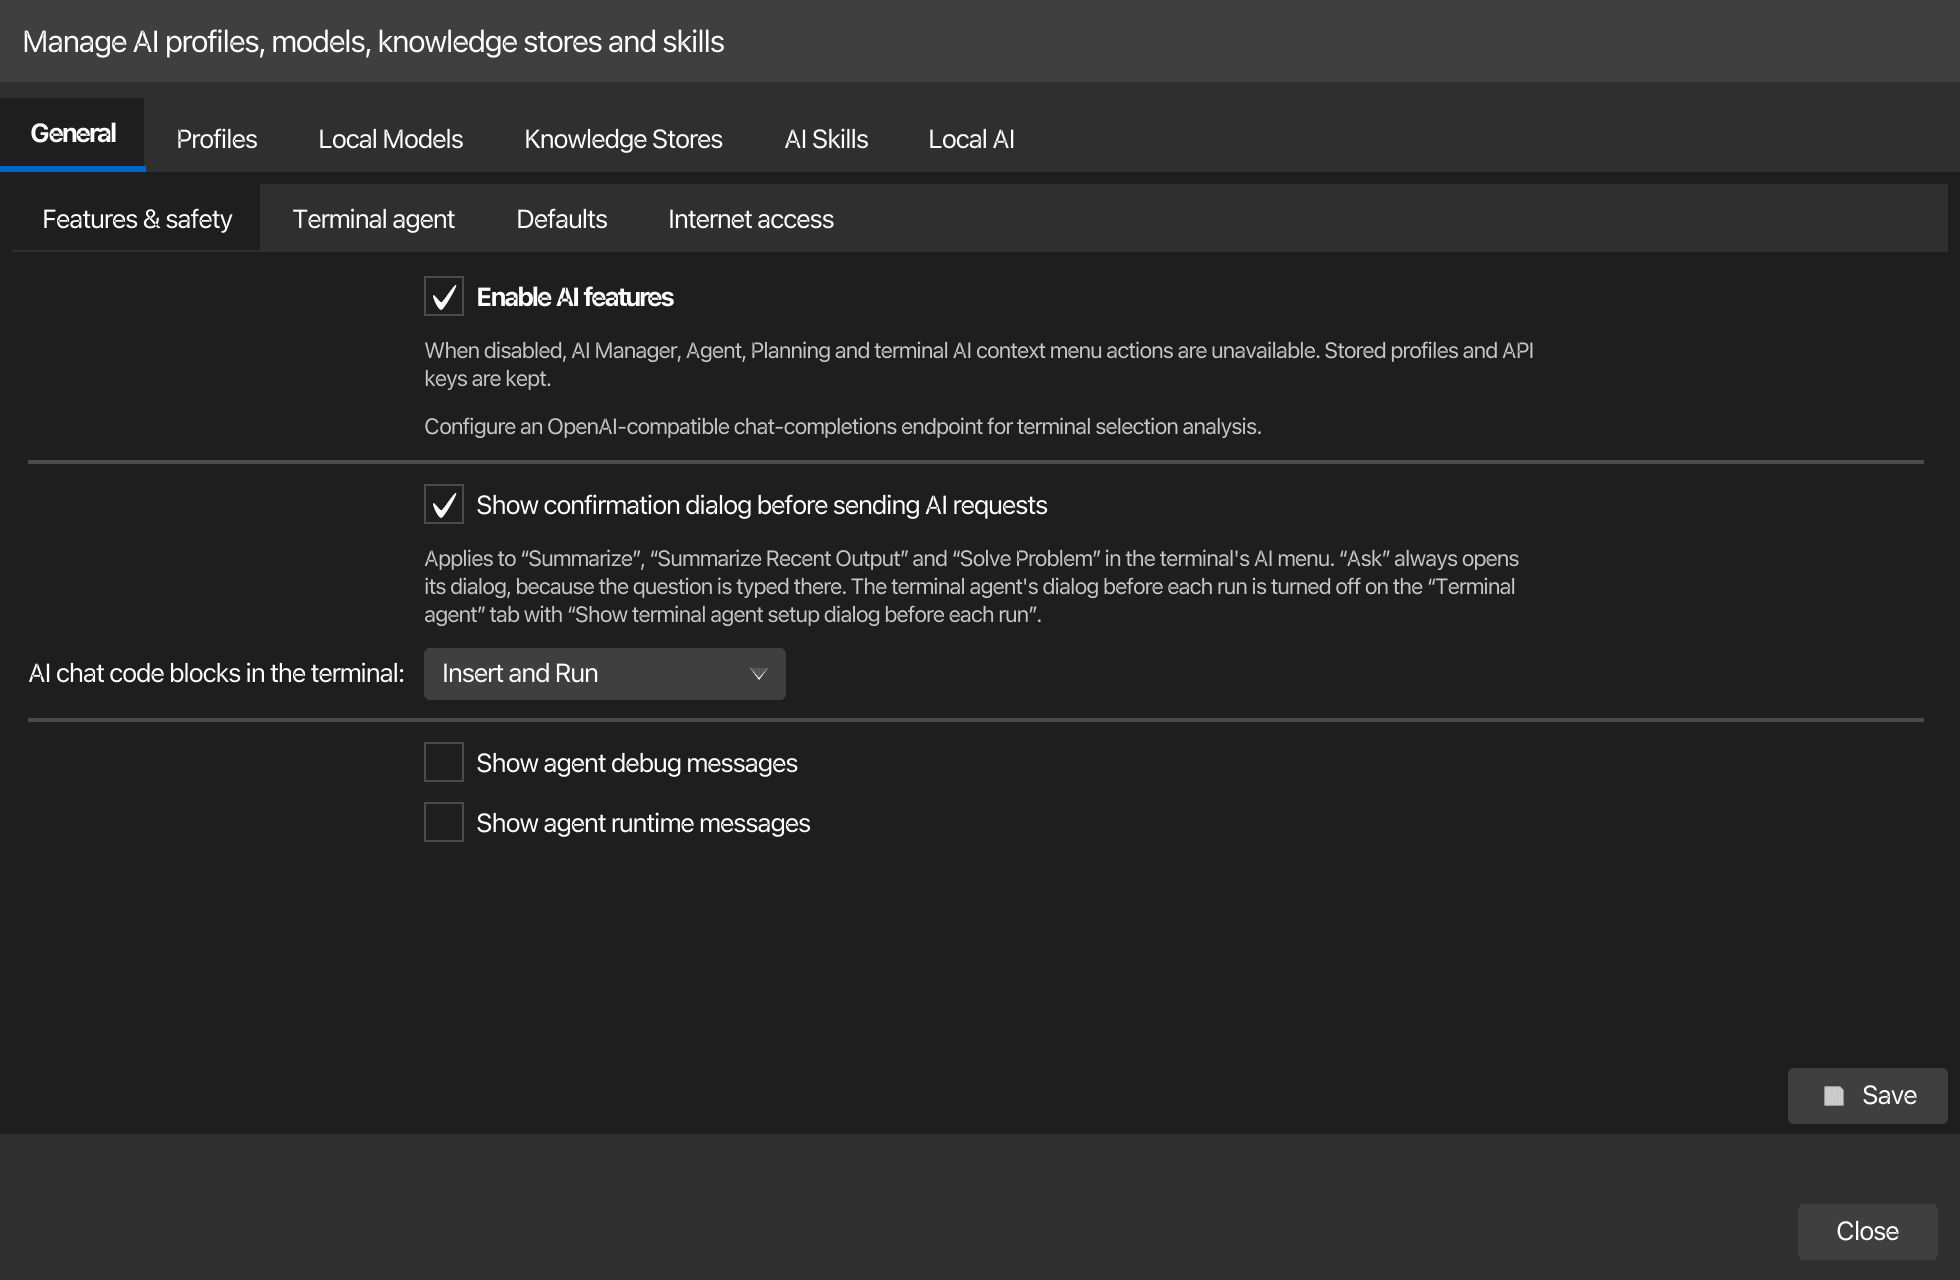
Jede KI-Einstellung befindet sich an einem Ort: KI → KI-Manager. Ihr erster Tab, Allgemein, enthält die Optionen, die nicht Teil eines Profils sind (Funktionsschalter, der Terminal-Agent, Vorgaben für Snippet-Aktionen, Internet-Tools) auf vier Abschnitts-Tabs; Profile enthält die KI-Profile mit ihrem Modell, ihrer Verbindung, ihren Grenzen und Budget; Lokale Modelle, Wissensspeicher, KI-Skills und Lokale KI den Rest. Die Werte werden in ~/.kortty/global-settings.xml gespeichert. Das Fenster Globale Einstellungen hat keinen KI-Tab mehr.
Suche im KI-Manager
Oben im KI-Manager, über seinen Tabs, befindet sich eine Suchzeile, ähnlich der Suche im Einstellungsdialog. Geben Sie ein Wort ein, und die passenden Optionen werden aufgelistet; die Auswahl einer davon öffnet deren Seite, scrollt zur Option und hebt sie hervor. Cmd+F (Ctrl+F unter Windows und Linux) springt von den Tabs und deren Seiten zur Suchzeile.
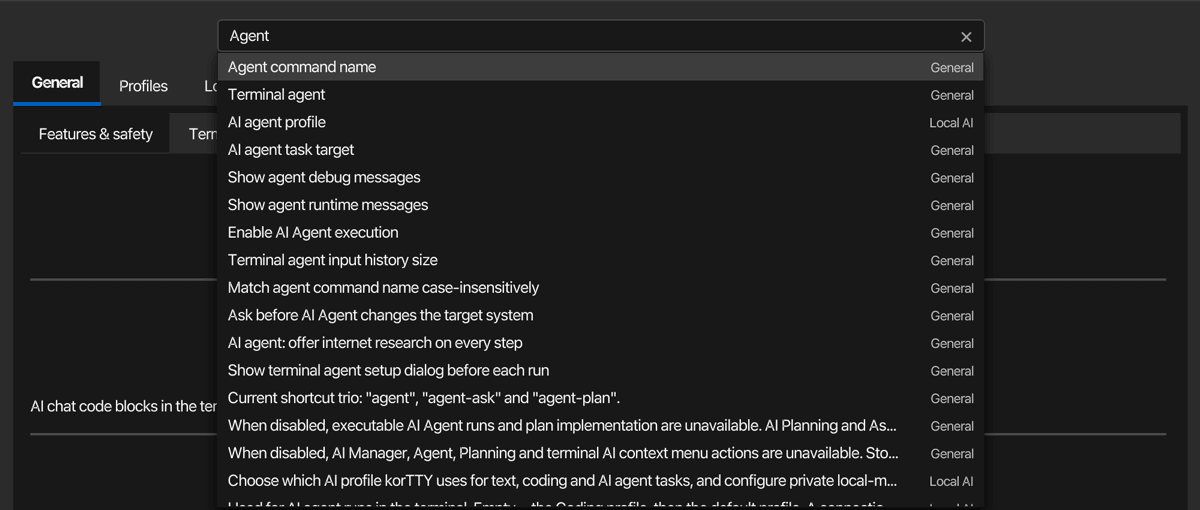
- Allgemein, Profile und Lokale KI werden über ihre eigenen Optionen durchsucht, auch bevor Sie ihre Tabs zum ersten Mal öffnen.
- Lokale Modelle, Wissensspeicher, KI-Skills und Memory werden über ihre Namen und über Schlüsselwörter gefunden, beispielsweise GGUF oder Hugging Face für Lokale Modelle, RAG oder embeddings für Wissensspeicher, GitHub oder import für KI-Skills sowie remember oder MEMORY.md für Memory.
- In den Editoren der Seiten KI-Skills und Memory behalten Cmd+F und Ctrl+F ihre eigene Suche im Editor; die Suchzeile wird dann mit der Maus erreicht.
Allgemeiner Tab
KI → KI-Manager → Allgemein gruppiert die globalen Optionen auf vier Abschnittstabellen. Speichern unter den Abschnitten schreibt alle; das Schließen des KI-Managers speichert sie ebenfalls.
| Abschnitt | Einstellungen |
|---|---|
| Funktionen & Sicherheit | KI-Funktionen aktivieren, Bestätigung vor dem Senden, KI-Chat-Codeblöcke im Terminal, Agenten-Debug und Laufzeitnachrichten |
| Terminal-Agent | Agent-Ausführung, Bestätigung vor Änderungen, Setup-Dialog vor jeder Ausführung, Komplexität einschätzen, Befehlsname und Groß-/Kleinschreibung, Aufgabenziel, Größe des Eingabeverlaufs |
| Standards | Security-Check-Profil, Standardsprache für KI-Text im Code, optionale Anweisungen im Snippet-Editor, Anzahl alternativer Lösungen |
| Internetzugang | Geheimnisse von Tavily, Bright Data und Brave Search, SearXNG-URL, MCP-Server-Labels und Plugin-IDs, „Internetrecherche bei jedem Schritt anbieten" |
Die Tabellen unten listen jede Einstellung dieser Abschnitte mit ihrem gespeicherten Schlüssel auf.
Kern-Einstellungen
| Einstellung | Typ | Werte | Standard | Speichert als |
|---|---|---|---|---|
| KI-Funktionen aktivieren | Schalter | — | Ein | aiFeaturesEnabled |
| Bestätigungsdialog vor Absendung von KI-Anfragen anzeigen | Schalter | — | Ein | aiConfirmBeforeSend |
| KI-Chat-Codeblöcke im Terminal | Dropdown | Aus (nur kopieren und speichern), Nur Einfügen, Einfügen und Ausführen | Einfügen und Ausführen | aiChatTerminalActions |
Wenn Bestätigungsdialog vor dem Senden an die KI anzeigen aktiviert ist, zeigen Zusammenfassen, Letzte Ausgabe zusammenfassen und Problem lösen im KI-Kontextmenü des Terminals an, was sie an die KI senden, und warten auf eine Bestätigung. Fragen öffnet immer seinen Dialog, da die Frage dort eingegeben wird. Der Terminal-Agent hat vor jedem Start einen eigenen Dialog; er wird unter KI-Agent im Terminal über Terminal-Agent-Abfrage vor jedem Start anzeigen deaktiviert.
KI-Chat-Codeblöcke im Terminal legt fest, welche Schaltflächen die Codeblöcke eines KI-Chats anbieten: Einfügen gibt einen Block an der Eingabeaufforderung eines Terminalbereichs ein, ohne Enter zu drücken, und Ausführen führt eine einzelne Shell-Befehlszeile nach einer Bestätigung aus. Die Unternehmensrichtlinie kann nur weitere Schaltflächen wegnehmen. Siehe Codeblöcke im Terminal.
KI-Agent im Terminal
| Einstellung | Typ | Werte | Standard | Speichert als |
|---|---|---|---|---|
| KI-Agent-Ausführung aktivieren | Schalter | — | Ein | terminalAgentExecutionEnabled |
| Frage vor der Änderung des Zielsystems durch den KI-Agent stellen | Schalter | — | Aus | terminalAgentConfirmMutatingCommandSets |
| Agent-Debugmeldungen anzeigen | umschalten | — | Aus | terminalAgentShowDebugMessages |
| Agent-Laufzeitmeldungen anzeigen | umschalten | — | Aus | terminalAgentShowRuntimeMessages |
| Terminal-Agent-Abfrage vor jedem Start anzeigen | umschalten | — | Ein | terminalAgentShowRunDialog |
| Komplexität einschätzen | Dropdown | Automatisch, Immer, Nie | Automatisch | aiAgentTriageMode |
| Agent-Kommando | Text | — | agent | terminalAgentCommandName |
| Den Agent-Befehl namensmäßig unabhängig von Groß- und Kleinschreibung abgleichen | umschalten | — | Aus | terminalAgentCommandNameCaseInsensitive |
| Ziel für KI-Agent-Aufgaben | Dropdown-Menü | Terminalfenster, Neues Chatfenster | Terminalfenster | terminalAgentExecutionTarget |
| Größe der Terminal-Agent-Eingabehistorie | Zahl | 5–100 | 20 | terminalAgentInputHistorySize |
Komplexität einschätzen bestimmt, wann der Agent vor der Ausführung Lösungsoptionen anbietet. Automatisch führt vor jeder Ausführung einen kleinen KI-Aufruf durch und bietet Optionen nur für Anfragen an, die komplex erscheinen, Immer bietet sie für jede Ausführung an, und Nie führt Anfragen so aus, wie sie sind. Swarm-Ausführungen und geplante Jobs bieten niemals Optionen an. Die Unternehmensrichtlinie kann die Einstellung mit triage unter [rule.ai-memory] sperren. Siehe Lösungsoptionen.
Memory-Tab
Der Memory-Tab des KI-Managers enthält das korTTY-Memory, die Regeln, die KI-Chat- und Agent-Anfragen mitführen. Seine Dateien, Bereiche, Bereinigung und der Schutz Ihres eigenen Textes werden in KI-Memory beschrieben.
| Einstellung | Typ | Werte | Standard | Speichert als |
|---|---|---|---|---|
| Memory verwenden | Schalter | — | Ein | aiMemoryEnabled |
| Lernen | Dropdown | Regeln vorschlagen, Aus | Regeln vorschlagen | aiMemoryLearningMode |
| Token-Budget | Zahl | 500–4000 | 1500 | aiMemoryMaxTokens |
Das Token-Budget ist der größte Speicherplatz, den eine einzelne KI-Anfrage mit sich trägt; Einträge, die nicht passen, werden aus dieser Anfrage ausgeschlossen, und eine Unternehmensrichtlinie kann das Budget senken. Im Modus Regeln vorschlagen prüft korTTY Ihre Nachrichten auf Inhalte, die für später aufbewahrt werden sollten, und schlägt sie als Regel vor; nichts wird ohne Ihre Bestätigung gespeichert. Aus findet keine Regeln.
KI-Profile
| Einstellung | Typ | Werte | Standard | Speichert als |
|---|---|---|---|---|
| Standardprofil | check box "Als Standardprofil verwenden" in the Profiles tab | ein Profil ist immer das Standardprofil | das erste Profil | defaultAiProfileId |
| Zeitlimit für KI-Anfragen | Zahl | 0 bis 1440 Minuten | 0 (kein Timeout) | aiRequestTimeoutMinutes |
| Security-Check-Profil | Dropdown-Kontrolle | (Liste der konfigurierten Profile; leer = Standardprofil verwenden) | — | securityCheckAiProfileId |
| Weitere Rechner im Netzwerk (Setup-Assistent Schnellstart) | Text | Host, host:port oder http:// URL, kommagetrennt; wird neben localhost abgefragt |
— | aiWizardScanHosts |
Das Security-Check-Profil ist ein spezielles KI-Profil für Snippet-Security-Check-Aktionen. Lassen Sie es leer (oder verwenden Sie Keine) um das Standardprofil zu verwenden. Es kann ebenfalls direkt im Fenster für das Snippet-Security Check festgelegt werden, und beide Orte teilen dieselbe gemerkte Einstellung.
Zeitlimit für KI-Anfragen ist die maximale Laufzeit einer einzelnen KI-Anfrage und gilt für jedes Profil. Der Standardwert 0 bedeutet, dass korTTY überhaupt kein Zeitlimit setzt: Langlaufende Aufgaben wie die Vollständige Code-Analyse des Snippet-Editors laufen, bis das Modell antwortet. Setzen Sie eine positive Anzahl von Minuten, um Anfragen abzubrechen, die dieses Limit überschreiten. Ein Profil kann den Wert überschreiben – siehe Zeitlimit für dieses Profil unten. Im KI-Manager ist der globale Wert die erste Zeile des Abschnitts Grenzen & Zeitlimits im Profil-Editor.
Im KI-Manager wird das Standardprofil über das Kontrollkästchen Als Standardprofil verwenden neben dem Profilnamen ausgewählt; da immer ein Profil das Standardprofil ist, verschiebt sich die Zuweisung, wenn das Kästchen bei einem anderen Profil angehackt wird.
Profil-Einstellungen (in Editor-Abschnitten)
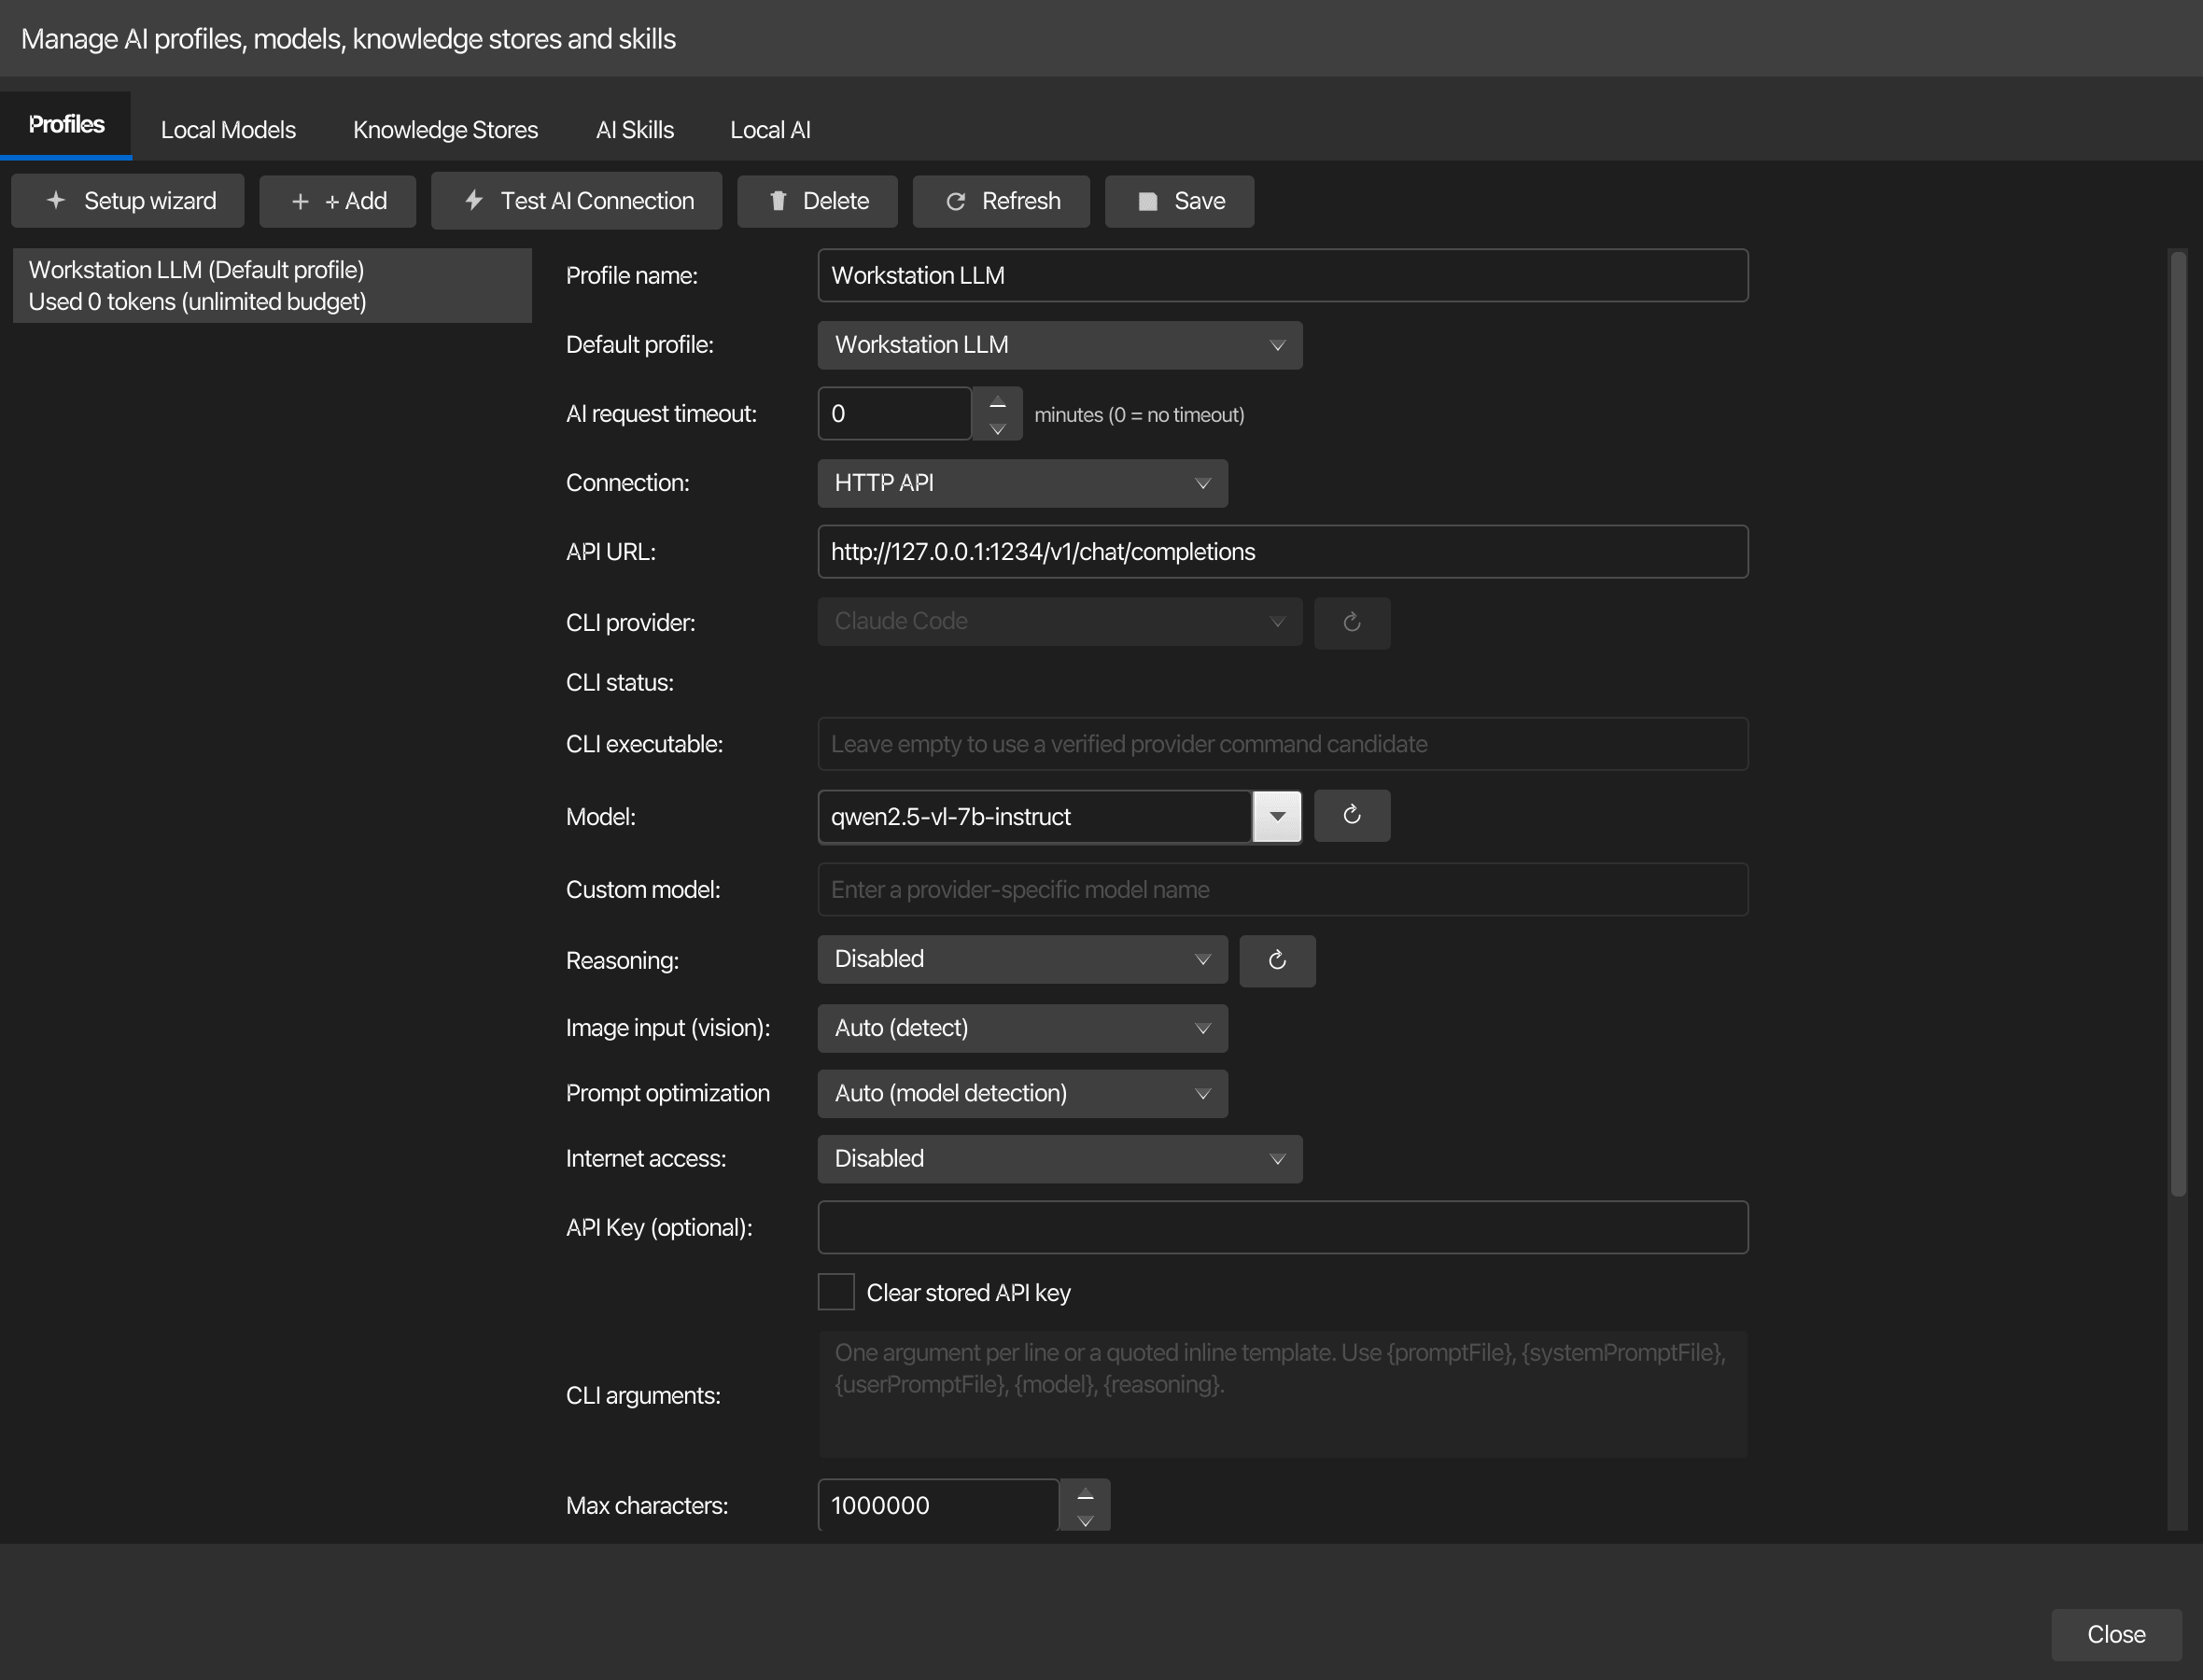
Die Profilfelder werden in KI > KI-Manager > Profile bearbeitet. Der Editor positioniert Profilname und Als Standardprofil verwenden oberhalb von vier Abschnitts-Tab, und die Abschnitte Verbindung und Modell & Fähigkeiten zeigen nur die Zeilen, die für den gewählten Verbindung-Modus gelten (die URL- und Schlüsselzeilen für HTTP-API, die CLI-Zeilen für Lokale CLI, eine Anmerkung für Integriertes llama.cpp und Integriertes MLX):
| Abschnitt | Felder |
|---|---|
| Verbindung | Verbindung, API-URL, Vertrauenswürdiger lokaler Endpunkt, API-Schlüssel (mit Gespeicherten API-Schlüssel löschen daneben), CLI-Anbieter, CLI-Status, CLI-Executable, CLI-Argumente |
| Modell & Fähigkeiten | Modell, Eigenes Modell, Kontextfenster (nur Integriertes llama.cpp), Reasoning, Bild-Eingabe (Vision), Prompt-Optimierung, Internetzugang |
| Grenzen & Zeitlimits | Zeitlimit für KI-Anfragen (gilt für jedes Profil, wird zuerst angezeigt), Maximale Zeichen, Zeitlimit für dieses Profil, Maximale Ausgabe-Tokens |
| Budget & Nutzung | Tokenizer, Maximale Tokens, Warnschwellen, Zurücksetzen, Preis pro 1 Mio. Tokens, Nutzung (der Kontingentbalken und die Nutzungszeile) |
| Einstellung | Typ | Werte | Standard | Speichert als |
|---|---|---|---|---|
| Profilname | Text | — | KI-Profil | (Feld Profil name) |
| Verbindung | Dropdown | HTTP-API, Lokale CLI, Integriertes llama.cpp, Integriertes MLX (Apple-Silizium; nur auf Mac-Geräten mit Apple-Silizium verfügbar) | HTTP-API | (Profilfeld connectionMode) |
| API-URL | Text | — | — | (Profilfeld apiUrl) |
| Vertrauenswürdiger lokaler Endpunkt: Terminal-Auswahlen ohne Maskierung von Geheimnissen senden | Kontrollkästchen | Nur verfügbar für ein HTTP-API-Profil, dessen API-URL auf localhost oder 127.0.0.1 liegt. Ein: Terminalauswahlen und angehängte Dateien erreichen diesen Endpunkt ohne Maskierung – schalten Sie es nur ein, wenn der Endpunkt das Modell selbst ausführt, nicht für einen Proxy oder eine SSH-Portweiterleitung zu einer Cloud-API. Siehe Maskierung von Geheimnissen vor dem Senden |
Aus | (profile trustedLocalEndpoint field) |
| CLI-Anbieter | Dropdown | (registrierte Anbieter) | — | (Profilfeld cliProviderId) |
| CLI-Executable | Text | — | — | (Profilfeld cliExecutablePath) |
| Modell | Dropdown/Text | (bearbeitbar; "Standard", vorgeschlagene Modelle von Cloud-Anbietern mit kurzen Vorschlägen plus live geladene Modelle; "Automatisch" nur für lokale LM Studio-Endpunkte) | — | (Profilfeld model) |
| Lokales GGUF-Modell | Dropdown | Installierte Chat-Modelle; verfügbar, wenn Verbindung Integriertes llama.cpp ist | — | (Profilfeld embeddedModelId) |
| Kontextfenster | Zahl + Schieberegler | 512 Tokens bis zur Kontextgröße, für die das ausgewählte GGUF-Modell trainiert wurde (aus der Datei gelesen); verfügbar, wenn die Verbindung Integriertes llama.cpp ist. Voreingestellt auf 32.768 Tokens (oder den trainierten Kontext, wenn dieser kleiner ist), sobald das Profil oder das Modell ausgewählt wird; eine Datei, die keinen trainierten Kontext angibt, erhält einen Bereich bis zu 131.072 Tokens. Der Wert gehört zum Modell und gilt daher für jedes Profil, das es verwendet, und entspricht Kontextgröße unter Lokale Modelle > Konfigurieren; ein größerer Kontext benötigt mehr RAM oder VRAM. Beim Speichern wird ein geladenes Modell gestoppt, damit der nächste Aufruf es mit der neuen Größe startet; ein Modell, das gerade eine Anfrage bearbeitet, behält seine Größe bei, und korTTY gibt dies an | 32.768 | (Modell contextSize in llm/models.xml) |
| Lokales MLX-Modell | Dropdown | Installierte MLX-Modelle; verfügbar, wenn Verbindung Integriertes MLX (Apple Silicon) ist | — | (Profilfeld embeddedModelId) |
| Eigenes Modell | Text | — | — | (Profil model Feld, geschrieben wenn das Modell-Dropdown auf Eigenes Modell für ein Lokales CLI-Profil gesetzt ist) |
| Prompt-Optimierung | Dropdown | Automatisch (Modellerkennung), Allgemein, Llama, Qwen, Mistral, Gemma, DeepSeek, Phi, GPT-OSS | Automatisch | (Profilfeld promptPreset) |
| Reasoning | Dropdown | Modell-Standard, Keine, Minimal, Niedrig, Mittel, Hoch, Extra hoch | Modell-Standard | (Profil-reasoningEffort-Feld) |
| Bild-Eingabe (Vision) | Dropdown | Automatisch (erkennen), Aktiviert, Deaktiviert | Automatisch (erkennen) | (Profilfeld visionSupport) |
| Internetzugriff | dropdown | Deaktiviert, KorTTY Tavily Tool, LM Studio Tavily MCP, Bright Data Web MCP, Brave Search MCP, SearXNG MCP, LM Studio Toolpack (gesperrt auf Deaktiviert, mit Hinweis, für eine native Anthropic Messages API URL) | Deaktiviert | (Profil internetAccessMode Feld) |
| API-Schlüssel (optional) | Text | (Passwortfeld) | — | (Profilfeld encryptedApiKey) |
| Maximale Zeichen | Zahl | 1–50.000.000 | 100.000 | (Profilfeld maxSelectionChars) |
| Zeitlimit für dieses Profil | Kontrollkästchen + Zahl | Eigenes Zeitlimit aus = globales Zeitlimit folgen; ein: 0–1440 Minuten (0 = niemals abgelaufen) | Aus | (Profilfeld requestTimeoutMinutes) |
| Maximale Ausgabe-Tokens | Kontrollkästchen + Zahl | Eigenes Limit aus = automatisch je Modell und Aktion; an: 256–1.048.576 Tokens pro Antwort | Aus | (Profilfeld maxOutputTokens) |
| Tokenizer | Dropdown | Schätzung, OpenAI cl100k_base, OpenAI o200k_base, OpenAI p50k_base, OpenAI r50k_base | Schätzung | (Profilfeld tokenizerType) |
| Maximale Tokens | Zahl + Einheit | (Menge: 0–1.000.000; Einheit: Tausende oder Millionen) | 0 (unbegrenzt) | (Profil tokenLimitAmount, tokenLimitUnit-Felder) |
| Warnschwellen | Zahl-Paar | Gelb %: 0–100, Rot %: 0–100 | 75%, 90% | (Profil tokenWarningYellowPercent, tokenWarningRedPercent-Felder) |
| Zurücksetzen | Zahl + Startdatum | Zeitraum: 1–3650 Tage; Startdatum | 30 Tage | (Profil tokenResetPeriodDays, tokenResetAnchorDate-Felder) |
| Preis pro 1 Mio. Tokens | zwei Zahlen + Währung | Preis für Eingabe und Ausgabe pro eine Million Tokens (Komma oder Punkt als Dezimaltrennzeichen; leer = kein Preis); Währung EUR, USD, CHF, GBP oder jeder ISO-Code. Bearbeitet in KI → KI-Manager → Profile | leer, EUR | (Profil pricePerMillionPromptTokens, pricePerMillionCompletionTokens, priceCurrency Felder) |
| KI-Verbindung testen | Schaltfläche | — | — | (nur Aktion) |
Snippet-Editor
| Einstellung | Typ | Werte | Standard | Speichert als |
|---|---|---|---|---|
| Standardsprache für KI-Texte im Programmcode | Dropdown-Kontrolle | (verfügbare Sprachoptionen) | — | aiCodeTextDefaultLanguage |
| Optionale zusätzliche Anweisungen für KI-Aktionen im Snippet-Editor anzeigen | Schalter | — | Aus | aiSnippetEditorAdditionalInstructionsEnabled |
| Maximale Anzahl alternativer Lösungen | Zahl | 1–10 | 3 | aiSnippetAlternativeSolutionCount |
Internetzugangskonfiguration
| Einstellung | Typ | Werte | Standard | Speichert als |
|---|---|---|---|---|
| Tavily-API-Schlüssel | Text | (Passwortsfeld) | — | encryptedAiTavilyApiKey |
| Bright-Data-API-Token | Text | (Passwortsfeld) | — | encryptedAiBrightDataApiToken |
| Brave-Search-API-Schlüssel | Text | (Passwortsfeld) | — | encryptedAiBraveSearchApiKey |
| SearXNG-URL | Text | — | — | aiSearxngUrl |
| Tavily-MCP-Serverlabel | Text | — | tavily | aiTavilyMcpServerLabel |
| Bright-Data-MCP-Serverlabel | Text | — | bright-data | aiBrightDataMcpServerLabel |
| Brave Search MCP-Plugin-ID | Text | — | — | aiBraveSearchMcpPluginId |
| SearXNG-MCP-Plugin-ID | Text | — | — | aiSearxngMcpPluginId |
| LM-Studio-Toolpack-MCP-Plugin-ID | Text | — | — | aiLmStudioToolpackMcpPluginId |
| KI-Agent: Internetforschung auf jedem Schritt anbieten | Schalter | — | Aus | aiAgentAlwaysOfferWebTools |
KI-Agent: Internetforschung auf jedem Schritt gilt ausschließlich für den KorTTY Tavily Tool-Modus. Wenn deaktiviert, erhält ein Terminal-KI-Agent-Schritt nur die Webtools, falls die Aufgabe ein Web-Signalwort oder eine URL enthält; wenn aktiv, erhält jeder Schritt diese Tools und das Modell entscheidet, ob eine Seite abgefragt oder gelesen werden soll.
Hinweise
KI-Profile
korTTY speichert mehrere benannte KI-Profile, jedes mit eigener Modellvariante, Verbindungsmethode, Vorgangsregeln, Prompt-Vorlage und optionalem Wissensspeicher. Jedes Profil verfolgt seine eigenen Token-Nutzung separat. Die Profile unterstützen drei Verbindungsmodi:
- HTTP-API: Direkte Verbindung zu einem OpenAI-kompatiblen REST-Endpunkt (geben Sie die API-URL, das Modellnamen und optional die API-Schlüssel an).
- Lokale CLI: Ausführung eines lokalen Befehlszeilen-Tools für KI (konfigurieren Sie den CLI-Anbieter, die benutzerdefinierte Ausführbarkeit, die Argumentenvorlage und den benutzerdefinierten Modellnamen).
- Integriertes llama.cpp: Wählen Sie den installierten Chat-GGUF im Lokalen GGUF-Modell aus. korTTY erhält einen privaten Loopback-
llama-server-Zugriff (Lease) dafür; die API-URL und das Profil-API-Schlüssel werden von korTTY verwaltet und sind nicht bearbeitbar.
Ein explizit gewähltes oder für Sicherheitsprüfungen bestimmtes Profil hat die höchste Priorität. Andernfalls verwenden Terminal-Textaktionen das konfigurierte Text-Profil, Code-Aktionen das Coding-Profil, und eine nicht zugewiesene Rolle fällt auf das Standardprofil zurück. Konfigurieren Sie diese Rollen und die Lokale Laufzeit unter KI > KI-Manager > Lokale KI; siehe Lokale Modelle mit llama.cpp. Ausführungen des Terminal-Agenten folgen ihrer eigenen Reihenfolge, die das Profil für den KI-Agenten umfasst; siehe Einstellungen des lokalen KI-Managers.
Der KI-Manager ist moduslos und kann während der Nutzung des Hauptfensters geöffnet bleiben. Ein erneutes Aufrufen des Managers führt dazu, dass der gleiche Manager für das Hauptfenster wiederhergestellt und gefokussiert wird, und der offene primäre Abschnitt bleibt bei Interaktion mit den Steuerelementen sichtbar mit einem fett unterstrichenen Akzent.
Einstellungen des lokalen KI-Managers
KI > KI-Manager > Lokale KI gruppiert diese Einstellungen in drei Tab-Abschnitten: Profil-Rollen (die vier Profil-Auswahlfelder), Lokale Laufzeit (Laufzeit-Updates, bevorzugtes Backend, RAG-Embedding-Modell-ID) und Hugging Face (der Token). Über Speichern unter den Abschnitten werden alle davon gespeichert.
| Wert für | Werte | Standard | als gespeichert |
|---|---|---|---|
| Profil für Text und Übersetzung | konfiguriertes KI-Profil oder Standard verwenden | Standard verwenden | textAiProfileId |
| Coding-Profil | konfiguriertes KI-Profil oder Standard verwenden | Standard verwenden | codingAiProfileId |
| Profil für den KI-Agenten | Konfiguriertes KI-Profil oder leer (dann das Coding-Profil, dann der Standard) | Leer | terminalAgentAiProfileId |
| Sitzungsjournal-Profil | konfiguriertes KI-Profil oder Standard verwenden | Standard verwenden | sessionJournalAiProfileId |
| RAG-Embedding-Modell-ID | Installiertes lokales Embedding-Modell | — | ragEmbeddingModelId |
| llama.cpp Runtime-Updates | Aus, Benachrichtigen, Stabile Updates automatisch installieren | Benachrichtigen | llamaRuntimeUpdatePolicy |
| Bevorzugtes Runtime-Backend | Auto/CPU/Metal unter macOS; Auto/CPU/Vulkan unter Windows/Linux | Auto | preferredLlamaRuntimeBackend |
| Hugging Face token | Optionales verschlüsseltes Token für begrenzte/private Repositorys | — | encryptedHuggingFaceToken |
Das Profil für den KI-Agenten ist die Rolle des KI-Agent im Terminal. Das Profil eines Laufs wird in dieser Reihenfolge gewählt: zuerst das Profil, das im Setup- oder Plan-Dialog des Laufs ausgewählt wurde oder im Agenten-Befehl benannt ist; dann das eigene KI-Profil der Verbindung; dann das Profil für den KI-Agenten; dann das Coding-Profil; und schließlich das Standardprofil. Ein Profil, das nicht mehr existiert, wird übersprungen und das nächste Level gilt. Ein leeres Profil für den KI-Agenten behält das vorherige Verhalten bei, nämlich das Coding-Profil und dann das Standardprofil. Ask-Läufe verwenden dieselbe Reihenfolge.
Automatisch (aktives Backend beibehalten) behält das aktive Runtime-Paket-Backend für Updates. Bei fehlenden installierten Paketen wählt Auto standardmäßig Metal unter macOS und CPU an anderen Orten. Das Starten eines Modells, das für ein anderes unterstütztes GPU-Backend konfiguriert ist, bietet die Installation des entsprechenden signierten Pakets an.
Der Local Models > Einrichtungsassistent bietet optionale Text-, Coding- und RAG-Embedding-Slots an. Er überprüft jede ausgewählte feste Revision, Quantisierung, Lizenz und genaue Größe vor dem Start des asynchronen Runtime/Modell-Installationsprozesses, führt für jedes installierte GGUF ein echtes Chat- oder Embedding-Test durch und speichert die resultierenden Rolle-Zuweisungen erst dann, wenn alle Tests erfolgreich sind. Die Text- und Coding-Slots können ein gemeinsames Modell teilen. Konfigurieren weigert sich, die persistierten Runtime-Einstellungen eines Modells zu ersetzen, während dieses eine aktive Anfrage bearbeitet.
Die Wissensspeicher, die der Text/Coding-Rolle zugewiesen sind, fügen lediglich begrenzte, zitierten Ausschnitte zu passenden normalen Terminal- und Snippet-KI-Anfragen hinzu, nie den gesamten Wissensspeicher. Ein Cloud-Text/Coding-Profil erhält diese Ausschnitte über seine konfigurierte Verbindung mit dem Anbieter, weshalb die Zuweisung des Wissensspeichers an diese Rolle oder Profil explizite Genehmigung für diese Offenlegung darstellt. Agenten, Planung, Swarm und geplante autonome Prompts bleiben eine separate Option; siehe Wissensspeicher für RAG.
Prompt-Optimierungsvorlagen
Automatisch (Modellerkennung) löst gängige Namen für Llama, Qwen, Mistral/Mixtral, Gemma, DeepSeek, Phi und GPT-OSS auf. Ein Familienprofil bietet präzise Hinweise zur Kompatibilität, bleibt jedoch bei den strengen JSON/Code-Verträgen von korTTY. Generisch liefert keine familienbezogenen Hinweise. llama.cpp wendet den eingebauten Chat-Vorlage des GGUF an.
Einstellungen für das Denkverhalten
Die Einstellung für das Denkverhalten bestimmt, wie gründlich die KI vor der Antwort nachdenkt. Die verfügbaren Ebenen hängen vom Modell und dem Endpoint ab:
- Modell-Standard: Es wird kein Reasoning-Parameter gesendet, sodass die Standardeinstellung des Modells gilt. Ein Modell, das standardmäßig Reasoning aktiviert hat, wie z. B. Qwen in LM Studio, denkt weiter.
- Keine: Schaltet das Reasoning explizit mit dem vom Transport unterstützten „Aus“-Wert ab. Wählen Sie diese und nicht Modell-Standard, um ein Reasoning-Modell vom Denken abzuhalten.
- Minimal: Leichtes Reasoning; schnellste Ausführung.
- Niedrig: Geringe Anstrengung bei der Reasoning; Balance zwischen Geschwindigkeit und Tiefe.
- Mittel: Mittlere Anstrengung; angemessene Tiefe.
- Hoch: Hohe Anstrengung; umfassendere Begründung.
- Extra hoch: Maximaler Begründungsanstrengung; am langsamsten, aber umfassendest.
Nicht alle Modelle unterstützen alle Stufen. Wenn LM Studio capabilities.reasoning.allowed_options über seine native Modellmetadaten veröffentlicht, verwendet korTTY diese genaue Liste anstelle eines stillschweigend konvertierten Werts als unterstützt und liest diese Liste automatisch: Die Auswahl eines anderen Modells oder Endpunkt im Profileditor liest die Metadaten für das gerade gewählte Modell erneut, sodass die Dropdown-Liste dem Profil ohne weitere Aktionen folgt. Die Liste wird hier ausschließlich aus den Modellmetadaten des Endpunkts gelesen — einer einzigen Anfrage, die kein Prompt sendet. Verwenden Sie die Schaltfläche Reasoning-Optionen aktualisieren, wenn Sie eine erneute Prüfung erzwingen möchten oder für einen Endpunkt, der keine solchen Metadaten veröffentlicht: Diese Schaltfläche führt auch aktive Verbindungstests durch. Diese Tests zählen, wie KI-Verbindung testen, eine Antwort, die nur als Reasoning vorliegt, als funktionierende Verbindung, da ein Modell, das standardmäßig denkt, das kurze Antwortbudget des Tests für Reasoning verwenden kann, bevor es eine Antwort formuliert.
Für ein binäres off/on-Modell schaltet eine explizite none-Anfrage diese Funktion aus, während das Auslassen des Reasoning-Parameters den vom Modell veröffentlichten Standardwert verwendet; die nicht unterstützten Stufen Minimal, Niedrig, Mittel, Hoch und Extra hoch werden nicht angeboten. Ein Modell, dessen LM Studio-Metadaten keine Reasoning-Fähigkeit ausweisen – einschließlich eines virtuellen Modells, das seine Reasoning-Metadaten auf falsch überschreibt – bietet nur Modell-Standard: LM Studio überspringt einen zur Laufzeit angeforderten, nicht unterstützten Reasoning-Wert mit einer Log-Warnung anstelle der Ablehnung der Anfrage, sodass eine aktive Sonde jede Stufe als unterstützt ansehen würde.
Eine erkannte Liste gehört dem Endpoint und dem Modell an, für das sie gelesen wurde. Änderungen an entweder der Konfiguration oder dem Modell führen dazu, dass die Liste verworfen wird. Wird von korTTY das Metadaten der neuen Kombination nicht gelesen — beispielsweise ein CLI-Profil oder ein Cloud-Endpoint — fällt das Profil auf die konservativen Standardwerte für den Modellnamen zurück, bis Sie Reasoning-Optionen aktualisieren. Ein Level, das nicht mehr angeboten wird, wird aus der Anfrage entfernt, wobei eine Log-Zeile den tatsächlich verwendeten Level benennt. Felder, die vom eigenen Verbindungsmodus des Profils nicht verwendet werden, wie beispielsweise der CLI-Anbieter eines HTTP-Profils, verursachen nie eine Ungültigkeit einer erkannten Liste. Profile, die ein integriertes Modell verwenden, behalten ihre erkannten Levels.
Für MiniMax-Endpunkte (direkt oder über einen Aggregator, dessen Modellname minimax enthält) werden sowohl Modell-Standard als auch ein explizites none als MiniMax’ eigener Parameter thinking: disabled gesendet, da diese Modelle reasoning_effort ignorieren und andernfalls standardmäßig denken – wobei das versteckte Reasoning als Completion-Tokens abgerechnet wird und bei MiniMax-M3 die Antwort mit einem inline <think>-Block beginnt. Eine explizite Anstrengungsstufe wird unverändert weitergegeben.
Für MiniMax wird die OpenAI-kompatible URL https://api.minimax.io/v1/chat/completions verwendet anstatt dem nativen /text/chatcompletion_v2-Endpoint: Der native Endpoint antwortet mit HTTP 200 und einem Fehlerobjekt, wenn ein falscher Schlüssel, ein falsches Modell oder ein leerer Balance-Status vorliegt, was korTTY nun als eigenes Provider-Meldung anzeigt, während der OpenAI-kompatible Endpoint diese mit einem korrekten HTTP-Status meldet.
Für den nativen Anthropic-(Claude-)Endpunkt fordert ein aktiviertes Reasoning-Level erweitertes Denken mit einem vom Level abhängigen Denkbudget an; Modelle, die erweitertes Denken nicht unterstützen, werden einmal ohne es erneut angefragt. Das Budget bleibt immer unter dem Ausgabelimit der Anfrage — siehe Ausgabelimit pro Antwort. Das Reasoning des Modells wird in den 💭-Denkzeilen des Terminal-KI-Agenten angezeigt.
Ausgabelimit pro Antwort
Maximale Ausgabe-Tokens begrenzt, wie viele Tokens eine Antwort einschließlich Denken verwenden darf. Ist Eigenes Limit aus, wählt korTTY das Limit automatisch. Der Wert kann ein Limit nur senken, nie erhöhen: Aktionen mit eigenem Sicherheitslimit — ein Mermaid-Diagramm (32.768 Tokens), eine Snippet-Bearbeitung mit vollständiger Ersetzung, die Code-Vervollständigung (4.096 Tokens) oder ASCII-Art — behalten dieses Limit, auch wenn das Profil mehr zulässt.
Bei der nativen Anthropic (Claude)-Endpunkt ist die Begrenzung jeder Anfrage das Minimum aus dem Sicherheitslimit der Aktion, dem Profil-Maximale Ausgabe-Tokens, dem dokumentierten Ausgabelimit des Modells und 16.000 Tokens. korTTY kennt die Ausgabelimits der aktuellen Claude-Familien (Opus 5, Sonnet 5, Fable 5 und Mythos 5, Opus 4.6–4.8 sowie Sonnet 4.6 bei 128.000 Tokens; Opus 4.5, Sonnet 4.5 und Haiku 4.5 bei 64.000 Tokens); jedes andere Modell erhält 4.096 Tokens, sofern das Profil kein eigenes Limit setzt. Die 16.000-Token-Decke gilt, weil korTTY Anthropic-Antworten noch nicht streamt, und Anthropic empfiehlt Streaming für größere Ausgaben, damit eine lange, stille Anfrage nicht abgeschnitten wird. Ein Denkbudget wird immer strikt unterhalb des Limits angepasst – verkleinert, wenn zu wenig Platz für die Antwort bleibt, und verworfen, wenn es unter Anthropics Minimum von 1.024 Tokens fällt. Wenn die API eine Anfrage wegen max_tokens ablehnt, weil sie zu hoch für das Modell ist, versucht korTTY es einmal mit dem im Fehler genannten Limit erneut. Wenn ein Anforderungs-Timeout gesetzt ist, erhöht korTTY es für ein großes Limit, damit die Antwort Zeit hat zu kommen (etwa 7,5 Minuten für 16.000 Tokens); ohne Timeout ändert sich nichts.
Bei OpenAI-kompatiblen Endpunkten wird der Profilwert als max_tokens für jede Anfrage gesendet, die kein eigenes Aktionslimit hat.
Bild-Eingabe (Vision)
Bild-Eingabe (Vision) entscheidet, ob korTTY Bilder zu einem Prompt für dieses Profil anhängen darf – verwendet von der KI-Bildschirm-Aufnahme-Analyse des Session-Journal. Automatisch (erkennen) ermittelt die Fähigkeit vom Endpunkt: für einen lokalen LM Studio-Endpunkt sind die Modell-Metadaten autoritativ (ein vlmModell gilt als bildfähig; die Antwort wird zusammen mit den Reasoningsstufen – durch das automatische Metadaten-Lesen und durch Reasoning-Optionen aktualisieren – gelesen und mit ihnen zwischengespeichert), der native Anthropic-Endpunkt gilt immer als bildfähig, und andere Endpunkte werden anhand bekannter Vision-Modellnamen erkannt (GPT-4o/4.⅕, o3/o4, Gemini, Gemma 3, Qwen-VL, LLaVA, Pixtral und ähnliche). Aktiviert/Deaktiviert überschreiben die Erkennung für Modelle, die falsch eingeschätzt werden. CLI- und integrierte (llama.cpp/MLX) Profile können keine Bilder senden. Lokale LM Studio-Vision-Modelle (vlm) erscheinen ebenfalls im Modell-Dropdown.
Token-Quoten-Verwaltung
Jedes KI-Profil verfügt über ein Token-Verbrauchslimit mit den folgenden Einstellungen:
- Tokenizer: Wählen Sie den Token-Tokenizer aus, der die Tokenanzahl schätzt — nützlich, wenn zwischen OpenAI und anderen Anbietern gewechselt wird. Mögliche Optionen sind Schätzung (allgemein), cl100k_base (GPT-3.5/4), o200k_base (o1/o1-mini), p50k_base (Codex) und r50k_base (GPT-2).
- Maximale Tokens-Grenze: Legen Sie ein Ausgabenlimit (in Tausend oder Millionen von Tokens oder unbeschränkt) fest. Die Tokenanzahl wird nach einem gleitenden Zeitplan neu berechnet.
- Reset-Periode: Anzahl der Tage zwischen den Resets (1–3650), wobei ein optionaler Referenzdatum für vorhersehbare Resetzeiten verwendet wird.
-
Warnschwellen: Eine gelbe Warnung wird bei einem bestimmten Prozentsatz der Grenze ausgelöst; eine rote Warnung bei einem höheren Prozentsatz. Beide Werte können als ganze Zahlen zwischen 0 und 100 konfiguriert werden.
-
Preis pro 1 Mio. Tokens (nur im KI-Manager, optional): der Preis, den der Anbieter pro eine Million Eingabe- und Ausgabe-Tokens verlangt. Mit einem Preis zeigt korTTY, was KI-Aufrufe kosten in Geld – neben der Quotenleiste als „≈ 3,42 € in diesem Zeitraum“, auf Sitzungsjournale und im KI-Swarm Dashboard-Header. Ein Profil, das lokal läuft (ein integriertes llama.cpp/MLX-Modell oder ein Endpunkt auf
localhost/127.0.0.1), wird stattdessen als „lokal · keine Token-Kosten“ angezeigt.
Die Token-Nutzung wird im Profil-Editor als farbige Balken und Zusammenfassung angezeigt, und die Profilliste zeigt den Tokenstatus inline. Die Nutzung wird für jeden KI-Aufruf gezählt, der mit dem Profil ausgeführt wird: Chat-Antworten, der Terminal-KI-Agent, jeder Agent eines KI-Swarms im Lauf plus seine endgültige kombinierte Antwort, geplante KI-Jobs und jeder Aufruf des Sitzungsjournals (Zusammenfassungen, Titel, Screenshot-Analyse, Fragen, Übersetzungen).
Internet-Zugriffs-Modi
Pro-Profil-Strategie für den Internetzugriff bei KI-Anfragen. Jeder Modus erfordert unterschiedliche Anmeldeinformationen und eine MCP-Konfiguration:
- Deaktiviert (Standard): Kein Internetzugriff.
- KorTTY Tavily Tool: Integrierte Web-Suche mithilfe der Tavily-API direkt (erfordert Tavily-API-Schlüssel).
- LM Studio Tavily MCP: Websuche über eine LM Studio Tavily MCP-Instanz (erfordert Tavily-API-Schlüssel und MCP-Server-Bezeichnung).
- Bright Data Web MCP: Strukturierte Datenextraktion und Durchsuchen über Bright Data Web MCP (erfordert Bright-Data-API-Token und MCP-Server-Label).
- Brave Search MCP: Suchen über Brave Search MCP (erfordert Brave-Search-API-Schlüssel und MCP-Plugin-ID im
mcp/<server_label>-Format). - SearXNG MCP: Suchen über eine SearXNG MCP-Instanz (erfordert SearXNG-URL und MCP-Plugin-ID im Format
mcp/<server_label>). - LM Studio-Toolpack: Community-LM Studio-Toolpack-Web-Suchserver (erfordert Plugin-ID im Format
mcp/<server_label>).
Die Anmeldeinformationen werden verschlüsselt und sicher gespeichert. Verwenden Sie den Keinen-Schalter neben jedem Geheimnisfeld, um die gespeicherten Werte beim nächsten Speichern zu löschen.
Integrierte Profile unterstützen ausschließlich das KorTTY Tavily Tool
Ein Profil, dessen Verbindungsmodus Integriertes llama.cpp oder Integriertes MLX ist, kann verwenden KorTTY Tavily Tool und nichts sonst. Die fünf MCP-Mode leiten die Anfrage über LM Studio's native API, das ein eingebettetes Modell niemals durchläuft – die Auswahl eines auf einem eingebetteten Profil falscht die Anfrage mit einer expliziten Nachricht statt stumm ohne Webzugriff zu antworten. Lokale CLI-Profile verfügen über keine Internet-Modi; das Dropdown-Menü ist für sie deaktiviert.
Native Anthropic Messages API-Profile (eine API-URL, die mit /v1/messages endet) haben ebenfalls keine Internet-Modi, weil korTTY keine Web-Tools an diese API sendet: das Dropdown ist auf Deaktiviert festgelegt, und ein Hinweis darunter erklärt warum. Ein von einer früheren Version gespeicherter Modus wird als Deaktiviert angezeigt, wenn das Profil geöffnet wird und hat keinen Einfluss auf Anfragen.
Eine Organisation kann den Web-Zugriff vollständig verbieten, indem sie den allow-internet-Policy-Schlüssel verwendet — siehe
Enterprise-Politik.